
 一把租约如何守住唯一 Active
这一篇关注什么
Ambari Server HA 的关键不在于“第二台 Server 能启动”,而在于两台进程对同一事实达成一致:谁持有当前任期,谁完成了接管恢复,谁才有资格对外写入。
控制权
Lease 决定当前有效期,Term 区分新旧任期,数据库保存全局一致的判断依据。
服务权
新 Active 先跨过晋升屏障,再以 readiness 告诉入口自己已经可以承接业务。
执行权
REST 写围栏与 Agent 二次校验共同拒绝旧 Term、双 Active 和过期命令。
config:
  target: _self
data:
  - name: 控制权
    desc: Lease 决定当前有效期,Term 区分新旧任期,数据库保存全局一致的判断依据。
    bgColor: '#eefaf4'
    textColor: '#176b4d'
  - name: 服务权
    desc: 新 Active 先跨过晋升屏障,再以 readiness 告诉入口自己已经可以承接业务。
    bgColor: '#eef6ff'
    textColor: '#1f4e79'
  - name: 执行权
    desc: REST 写围栏与 Agent 二次校验共同拒绝旧 Term、双 Active 和过期命令。
    bgColor: '#fff8e8'
    textColor: '#79520b'
2
3
4
5
6
7
8
9
10
11
12
13
14
15
如果把高可用只画成两个 Server 加一个负载均衡,图会很漂亮,却没有回答最危险的问题:网络分区时,两台 Server 都认为对方失联怎么办?旧 Active 卡顿后重新恢复,怎样阻止它继续下发过期命令?Standby 刚拿到租约,还没恢复完任务状态时,能不能立刻接收写请求?
Ambari Plus 的回答由五部分组成:共享数据库租约、单调递增的 Term、服务端写围栏、晋升屏障,以及 Agent 侧的二次校验。入口层的健康检查和浏览器恢复机制,则让这套后端状态能够被用户正确感知。
# 整体架构先展开看
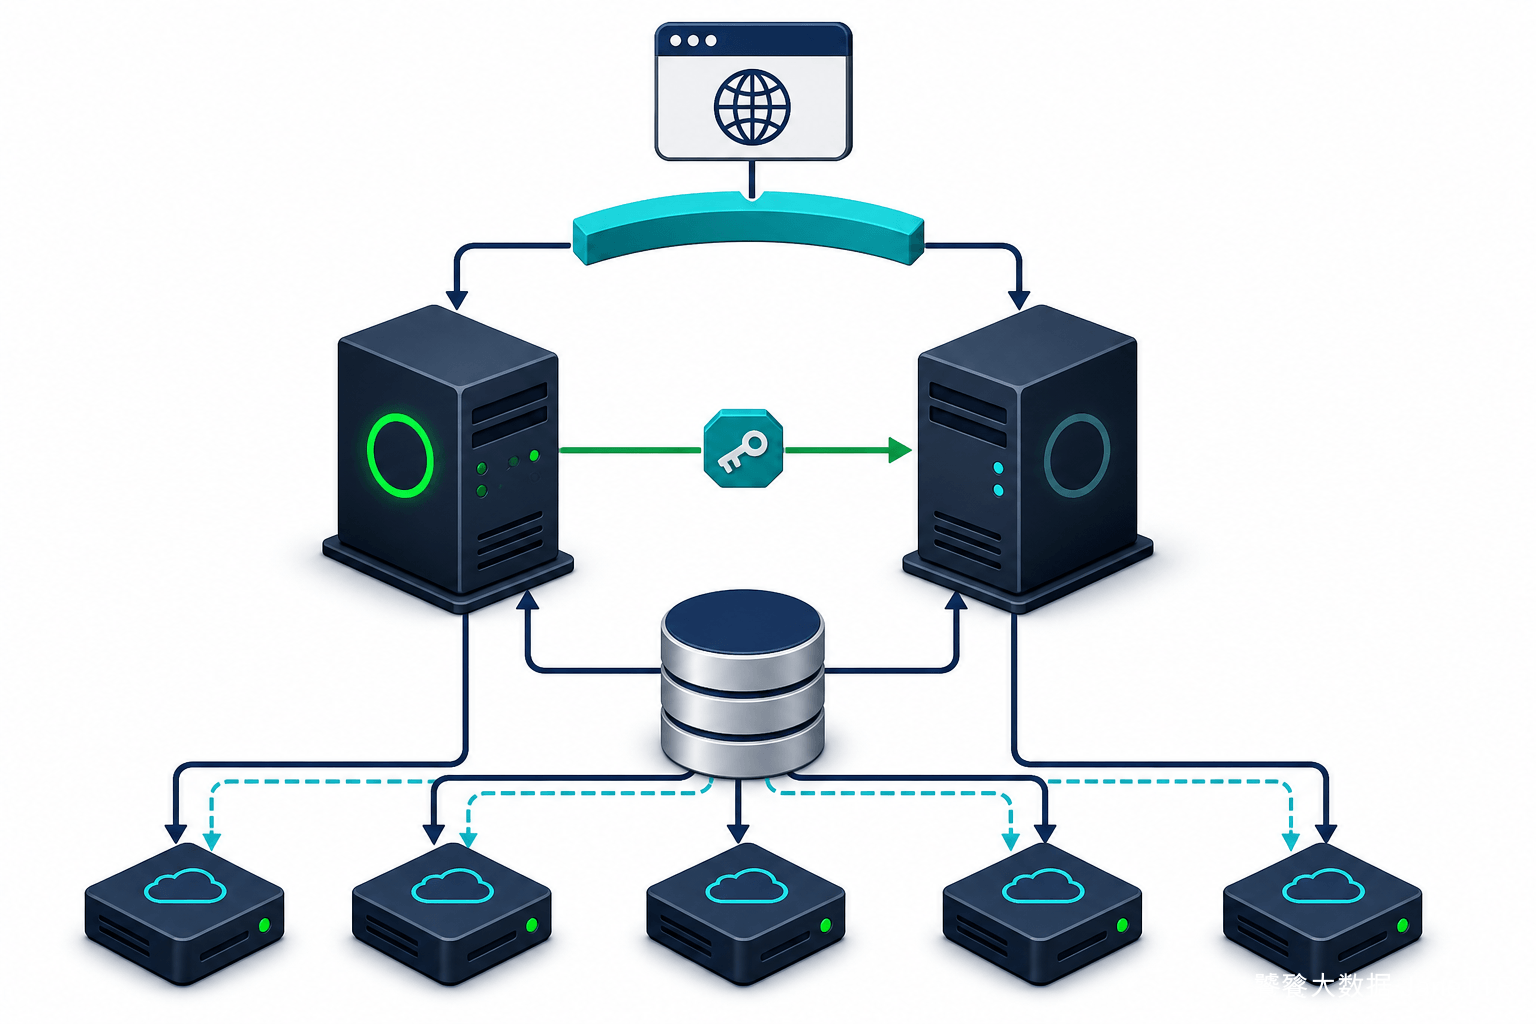
读图顺序
从上到下依次是访问入口、Active/Standby、共享数据库与 Agent。入口可以探测两台 Server,但只把业务流量交给 readiness 成功的 Active;两台 Server 共享数据库,Agent 保存两个候选并独立校验角色与任期。
这里有三个需要特别注意的事实:
- 两台 Server 连接的是同一个 Ambari 数据库,租约和任务状态不依赖某一台机器的本地磁盘;
- 负载均衡不负责选主,它只根据 Server 已经形成的角色与就绪状态转发请求;
- Agent 不是被动接受任意 Server,它会探测候选节点并校验角色、Term、epoch 与 TLS 身份。
# Lease:数据库中的限时通行证
Lease 可以理解为一张带过期时间的写入通行证。Server 成为 Active 后需要周期性续租;Standby 只能在旧 Lease 失效后尝试获取新 Lease。整个竞争通过共享数据库完成,所以不依赖两台 Server 能否直接互相通信。
当前默认参数如下,部署时可以根据数据库和网络时延评估,但不要为了追求更快切换随意压缩。
| 参数 | 当前默认值 | 含义 |
|---|---|---|
| Lease TTL | 15 秒 | 租约在没有续租时可保持多久 |
| 续租间隔 | 5 秒 | Active 正常情况下更新租约的节奏 |
| 协调轮询 | 2 秒 | 节点重新判断角色和恢复状态的频率 |
| Agent 重连分散窗口 | 10 秒 | 避免大量 Agent 在切换瞬间同时连接新 Active |
TTL 不是越短越好
数据库偶发抖动或虚拟机短暂停顿都可能延迟续租。TTL 过短会增加不必要切换;TTL 过长则会拉长故障检测。调整前应先测量数据库高分位延迟、时钟状态和实际故障恢复目标。
# 数据库失联时为什么要主动 Fenced
Active 无法访问数据库时,也无法证明自己的 Lease 仍然有效。此时继续处理写请求会产生脑裂风险,所以节点会进入 FENCED,拒绝普通读写和命令调度。即使本地记录的租约时间看起来还没到,也会使用单调时钟形成一道本地写入截止线,防止系统时钟回拨延长旧权限。
这是一种“宁可短暂不可用,也不允许两个控制者同时生效”的选择。对分布式控制面来说,这是正确性优先的必要代价。
# Term:识别新旧 Active 的任期号
每次成功接管都会形成新的 Term。Term 单调递增,它让服务端、Agent 和运维人员都能判断哪个 Active 更新。
例如:
Server A: Active,  Term 18
Server B: Standby, Term 18

Server A 故障
Server B: Active,  Term 19

Server A 恢复
Server A: Standby, Term 19
2
3
4
5
6
7
8
旧 Server A 即使保留着 Term 18 的内存状态,也不能覆盖 Term 19 的新 Active。API 写请求可以携带期望 Term,服务端发现请求过期时会明确拒绝;Agent 也只接受最高有效 Term 对应的 Active 会话。
Term 解决的是“先后关系”,Lease 解决的是“当前有效期”。两者配合,才能在进程暂停、网络分区和节点恢复这些场景里识别陈旧控制者。
# 五种角色状态,而不是简单的主与备
Server 实际运行时需要比 Active/Standby 更细的状态。
| 状态 | 典型场景 | 能否承接普通管理请求 |
|---|---|---|
SINGLE_ACTIVE | 尚未启用 HA 的单节点模式 | 可以 |
STARTING | HA 节点刚启动,尚未形成安全角色 | 不可以 |
ACTIVE | 已持有租约;还要结合 ready 状态判断 | 仅在完成晋升、Ready 后可以 |
STANDBY | 正常备节点,等待接管 | 不可以 |
FENCED | 租约、数据库或角色一致性无法确认 | 不可以 |
HA 模式下进程启动后先进入 STARTING,而不是乐观地把自己当作 Active。首次建立主备时,Standby 还会在关闭选举的状态下启动,只观察已有 Active;等主节点提交新的 HA epoch、Agent 候选配置完成后,才开启正式选举。
这一步很重要:安装完成和参与选举是两件事。把它们分开,可以避免半配置节点过早取得写权限。
# 晋升屏障:拿到租约还不能马上对外服务
Standby 获取新 Lease 后会进入 Active 恢复阶段。它需要重新建立对集群真实状态的认识,典型动作包括:
- 重新加载 Cluster、Service、Host 与配置状态;
- 恢复进行中或等待中的管理任务;
- 核对仓库和版本状态;
- 恢复告警定义与调度所需状态;
- 收敛凭据和安全相关运行信息。
只有这些步骤全部完成,节点才标记为 Ready。入口层的 /readiness 也只有在这个时刻返回成功。
正常晋升路径可以概括为 STARTING → ACTIVE_RECONCILING → ACTIVE_READY。如果启动节点观察到其他有效 Lease,它会进入 STANDBY;如果恢复失败、数据库不可确认或续租丢失,它会进入 FENCED,待看到更新 Term 后再以 Standby 身份收敛。
我更愿意把它理解为一扇“晋升屏障”:角色先变化,能力后开放。这样负载均衡不会把用户送到一个刚接管、但内部状态还没准备好的节点。
# 写围栏:所有普通请求都必须经过角色判断
写围栏位于 REST 请求进入业务逻辑之前。它不只拦截 POST、PUT、DELETE,在 Standby 上连普通业务查询也默认不放行,因为某些看似只读的路径可能依赖 Active 的运行状态,或者让调用方误判节点已经可用。
Standby 只保留少量用于发现和恢复的接口:
| 接口 | 作用 |
|---|---|
/api/v2/control-plane/ha/liveness | 证明进程存活,不代表可接收业务 |
/api/v2/control-plane/ha/readiness | 只有当前 Active Ready 时返回成功 |
/api/v2/control-plane/ha/agent-status | 供 Agent 判断角色、Term、epoch 和就绪状态 |
| HA 概览与发现接口 | 供管理页面展示当前拓扑 |
| 已存在 HA 操作的精确读取 | 接管后继续查看原操作,不重新提交写入 |
这种默认拒绝模式可以减少遗漏。如果以后新增了一个有副作用的 API,开发者即使忘记单独标注,它也不会自动在 Standby 上获得执行权限。
# Agent 为什么还要再选一次
只保护浏览器入口还不够。Ambari Agent 才是真正执行安装、启停、配置分发和安全变更的节点。如果旧 Active 仍能与 Agent 通信,服务端的 REST 围栏就无法阻止过期命令。
开启 HA 后,Agent 配置里会保存 Server 候选列表。Agent 只在建立或重新建立连接时探测候选节点,正常心跳期间不会每次都做全量选举。选择过程遵循这些规则:
- HTTPS 证书校验必须开启,避免候选身份被冒充;
- 候选必须报告
Active Ready; - 选择最高有效 Term,且 epoch 必须与当前 HA 配置一致;
- 如果同一最高 Term 出现多个 Active,Agent 拒绝选择,等待一致性恢复;
- 建立会话后,命令还要携带有效的 HA 信封和执行标识,避免旧会话或重复命令生效。
为什么要让 Agent 分散重连
大规模集群里,数百个 Agent 同时探测并连接新 Active 会形成“惊群”。默认 10 秒的随机分散窗口让连接逐步恢复,不会在晋升刚完成时瞬间打满 Server。
# 统一入口只认 readiness
如果前面使用 HAProxy 或已有负载均衡,健康检查必须访问 /readiness,不能只检测端口或 /liveness。
/liveness成功:Java 进程活着,Standby 也应成功;/readiness成功:节点是最新 Active,并且已完成晋升恢复;- TCP 端口可连:只说明有进程监听,无法证明角色安全。
入口摘除失去 Active 资格的节点时,还应关闭这个节点上的旧会话,避免长连接继续停留在过期 Server。代理层只可自动重试明确安全的读取请求,绝不能替用户重试创建任务、修改配置、启停服务等写操作。
# 浏览器如何度过切换窗口
当页面遇到明确的接管信号时,会暂停持续查询和事件流,进入一次集中的 readiness 检查。新 Active 就绪后,页面重新挂载当前视图,并按原操作标识读取持久化结果。
这里有两个边界:
- 只有明确的 HA 接管响应才进入全局恢复,普通业务返回的 503 仍按业务错误展示;
- 浏览器只恢复读取,不重放写请求。
这一点看似只是前端体验,实际上与后端的幂等设计同样重要。代理或页面若在切换时盲目重试写操作,再严密的 Server 选主也可能收到一笔新的、合法但重复的请求。
# 一次故障切换的完整时间线
| 时刻 | 控制面发生什么 | 入口与 Agent 应怎样响应 |
|---|---|---|
| T0:稳定运行 | Server A 持有 Lease,Term 为 N;Server B 处于 Standby | 入口只转发 A,Agent 会话保持在 A |
| T1:Active 失联 | A 无法续租或主动退出,B 仍等待旧 Lease 失效 | 入口摘除 A;页面暂停读取,禁止重放写请求 |
| T2:新任期形成 | B 获取 Lease,Term 增加到 N+1,进入恢复阶段 | B 的 liveness 可用,但 readiness 尚未成功 |
| T3:晋升完成 | B 恢复任务、配置与运行状态,进入 Active Ready | 入口转发 B;Agent 分散重连并接受最高 Term |
| T4:旧节点回归 | A 读取到 N+1,以 Standby 身份加入 | A 的 readiness 保持失败,不重新抢占业务 |
这条链路同时验证了控制权、服务就绪、入口转发、Agent 重连和旧节点回归。缺少其中任何一段,都只能算局部恢复。
# 架构评审时最值得追问的五件事
- 数据库中断时,旧 Active 是继续服务还是立即自我围栏?
- 新 Active 获取 Lease 后,要完成哪些恢复动作才会 Ready?
- Agent 如何拒绝旧 Term、双 Active 和未经 TLS 验证的候选?
- 负载均衡检查的是端口、liveness,还是严格的 readiness?
- 页面和调用方在切换时是否可能自动重放写请求?
如果这五个问题都有明确答案,高可用才从一张双节点架构图变成了可验证的控制协议。
# 接着看什么
下一篇沿着一次真实启用流程进入源码:为什么先做 mTLS,再远程安装 Standby;为什么候选切换分成准备和激活两阶段;失败后又怎样从持久化 Operation 继续。
从一次启用操作追到主备就绪
查看规划、安装、安全引导、主节点提交和 Agent 切换的实现分工。
把 Ambari Server HA 稳稳地跑起来
回到页面,用准备清单和验收表完成一次可复现的启用。
config:
  target: _self
data:
  - name: 从一次启用操作追到主备就绪
    desc: 查看规划、安装、安全引导、主节点提交和 Agent 切换的实现分工。
    link: /v/custom/thoughts/ambari-server-ha/implementation/
    bgColor: '#fff8e8'
    textColor: '#79520b'
  - name: 把 Ambari Server HA 稳稳地跑起来
    desc: 回到页面,用准备清单和验收表完成一次可复现的启用。
    link: /v/custom/thoughts/ambari-server-ha/enable/
    bgColor: '#eef6ff'
    textColor: '#1f4e79'
2
3
4
5
6
7
8
9
10
11
12
13