
 控制面不能只靠一台机器
先说结论
Ambari Server HA 保护的是集群管理控制面:当当前 Server 主机、进程或网络发生故障时,由另一台 Server 接管管理请求和 Agent 连接。它不会自动替代数据库高可用、组件自身高可用或入口负载均衡,这几层需要分别建设。
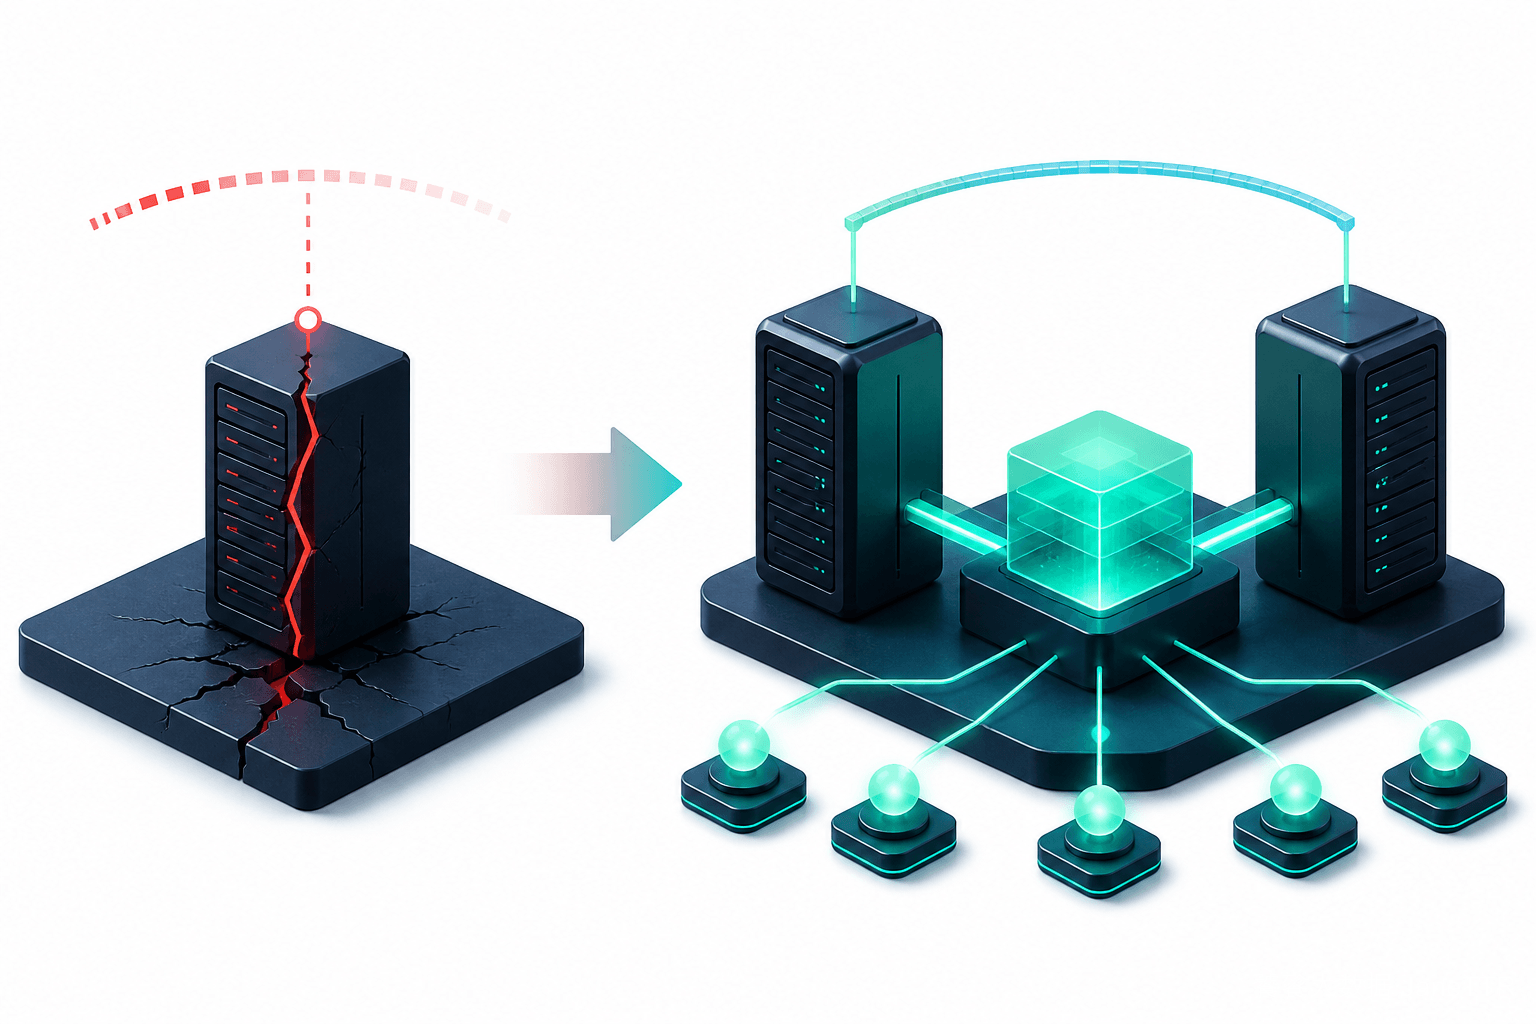
左侧是管理面单点,右侧是两台 Server 共享状态、由一个入口对外服务的主备控制面。图只表达风险变化,精确职责以后文表格为准。
先看影响
数据服务可能还在运行,但页面、API、Agent 和运维任务已经失去统一控制者。
再定边界
Server HA 负责唯一 Active 与接管;数据库、统一入口和组件 HA 仍需单独建设。
最后写验收
不以两个进程存活为完成,而以角色、Agent、任务、入口和旧节点回归为准。
config:
  target: _self
data:
  - name: 先看影响
    desc: 数据服务可能还在运行,但页面、API、Agent 和运维任务已经失去统一控制者。
    bgColor: '#fff1f0'
    textColor: '#8c2f2b'
  - name: 再定边界
    desc: Server HA 负责唯一 Active 与接管;数据库、统一入口和组件 HA 仍需单独建设。
    bgColor: '#eef6ff'
    textColor: '#1f4e79'
  - name: 最后写验收
    desc: 不以两个进程存活为完成,而以角色、Agent、任务、入口和旧节点回归为准。
    bgColor: '#eefaf4'
    textColor: '#176b4d'
2
3
4
5
6
7
8
9
10
11
12
13
14
15
我在做集群高可用规划时,经常会看到这样一种组合:HDFS 配了 NameNode HA,YARN 有 ResourceManager 主备,ZooKeeper 是奇数节点,数据库也做了主从,但 Ambari Server 仍然只有一台。业务数据面确实不太容易因为单机故障停掉,管理面却还悬在一个节点上。
平时这不显眼。Ambari Server 一旦不可用,已经运行的 HDFS、YARN、Hive 通常不会立刻停止,但新的运维动作会陆续受影响:页面打不开、告警无法汇总、配置无法下发、组件启停和扩容无法执行,Agent 也会不断尝试重新连接。故障若正好发生在升级、安装或安全改造期间,恢复难度还会进一步放大。
这就是 Ambari Server HA 的出发点:不把“组件还在运行”误认为“平台仍可管理”,而是让控制面也具备明确、可验证的接管能力。
# 单节点故障到底会带来什么
Ambari Server 不是一个只负责展示页面的 Web 进程。它处在浏览器、自动化调用、Ambari Agent、共享数据库和各服务管理脚本之间,承担了多个关键职责。
| 入口或对象 | Server 正常时负责什么 | Server 失联后的直接影响 |
|---|---|---|
| Web 与 REST API | 查询集群状态、保存配置、创建运维任务 | 页面和接口不可用,新的管理动作无法提交 |
| Ambari Agent | 接收心跳、下发命令、确认执行结果 | Agent 重连,命令和状态回报暂时中断 |
| 运维任务 | 保存阶段、主机任务和执行结果 | 进行中的任务无法继续推进或展示 |
| 告警与状态聚合 | 汇总主机、组件与服务健康度 | 告警视图逐渐失真,故障判断缺少统一入口 |
| 配置与凭据管理 | 读取版本化配置并向目标主机下发 | 变更、扩容、安全配置无法继续 |
因此,Ambari Server 的可用性目标不能只写成“再启动一台 Java 进程”。如果两台 Server 同时接受写请求,重复下发的安装、重启、删除或滚动升级命令可能比短暂不可用更危险。一个可用的主备方案至少要同时解决两个问题:
- 当前 Active 故障后,Standby 能在可控时间内接管。
- 任意时刻只有一个 Server 有资格处理写请求和下发命令。
第二条是整套设计的底线。高可用首先要防止双写和脑裂,然后才谈缩短恢复时间。
# 我们先把目标说清楚
Ambari Plus 里的 Server HA 采用 Active/Standby 模式。正常情况下,两台 Server 进程都可以存活,但只有租约持有者是 Active;Standby 观察集群状态、等待接管,不参与普通读写和命令调度。
# 目标一:故障时自动重新建立管理入口
当前 Active 进程退出、主机掉电或无法续租后,Standby 会竞争新的租约。接管不是简单地把角色改成 Active:新节点还需要重新加载集群、恢复任务状态、核对仓库与凭据等关键运行信息。只有这些步骤通过,才会进入可对外服务的 Active Ready 状态。
# 目标二:用围栏保护所有副作用
普通页面查询、REST 写请求、Agent 命令都不能只依据“本机进程还活着”决定是否执行。服务端需要同时检查当前角色、Term 和就绪状态;Agent 也要确认响应来自唯一、更新的 Active。旧 Active 即使因为网络分区暂时没有退出,也不能继续写数据库或向 Agent 发命令。
# 目标三:正在执行的任务有恢复依据
管理任务不能只保存在某个 JVM 的内存里。安装、启停、升级等操作的状态要落在共享数据库中,新 Active 接管后依据持久化状态继续判断,而不是把旧写请求再提交一次。对浏览器而言,短暂失联后的正确动作是重新读取已经存在的任务,而不是自动重放 POST 或 PUT。
# 目标四:启用过程本身也可回退
把单节点环境扩展成主备,会经过软件安装、数据库接入、TLS 材料准备、Agent 候选切换和选举开启等多步操作。任何一步失败都应该能看见明确状态,并从已完成阶段继续或恢复;不应留下一个“两个 Server 都启动了,但 Agent 不知道该连谁”的半成品。
# 高可用不是一个开关,而是四层协作
先把容易混在一起的几层拆开看。Server 角色、数据库、访问入口和组件服务分别有自己的可用性责任,任何一层都不能用另一层的“正常”代替。
| 层次 | 需要解决的问题 | Server HA 是否直接提供 |
|---|---|---|
| Server 角色层 | 唯一 Active、Standby 接管、写围栏 | 是 |
| 数据库层 | Ambari 元数据持续可读写 | 否,需要外部数据库高可用或稳定的数据库入口 |
| 访问入口层 | 用户和 API 始终找到当前 Active | 可使用两个直连端点;生产通常另配 HAProxy 或已有负载均衡 |
| 组件服务层 | NameNode、ResourceManager、HiveServer2 等自身不中断 | 否,仍按各组件的 HA 方案配置 |
不要把数据库放在待切换的 Server 本机
两台 Ambari Server 必须访问同一份、稳定的外部数据库。若元数据库只存在于当前 Active 本机,Server 主机故障时 Standby 即使成功启动,也无法读取租约、配置和任务状态。
# 为什么选择主备,而不是双活写入
Ambari 的管理请求经常带有明显副作用。例如“启动 HDFS”背后可能生成多个 Stage,再拆成不同主机上的 Task,由 Agent 逐条执行。两个 Server 同时调度同一个请求,会面对任务重复、顺序冲突、状态覆盖和补偿困难等一系列问题。
Active/Standby 把问题收敛为一条清楚的规则:
只有持有最新有效租约、完成晋升恢复且通过写围栏检查的 Server,才能改变平台状态。
这种方案牺牲了两台 Server 同时承载写流量的能力,却换来了更容易证明的正确性。对 Ambari 这种控制面来说,管理请求吞吐量通常不是首要矛盾,避免重复副作用更重要。
# 应该怎样理解“短暂失联”
Server HA 不等于浏览器永远看不到一次请求失败。故障检测、租约过期、Standby 晋升、入口摘除旧节点和客户端重连都需要时间。在这段窗口里,页面可能看到一次明确的接管中状态。
合理的体验应当是:
- 查询和任务状态流暂时暂停,待新的 Active 就绪后继续读取;
- 已经提交的运维任务通过原任务标识重新查询;
- 写操作不被浏览器、代理或 SDK 自动重试;
- 超过恢复窗口后,页面给出可执行的刷新、重连或人工检查建议。
因此验收时不能只证明“Standby 最终变成了 Active”,还要观察切换窗口内有没有重复任务、持续报错或错误地把失败显示成成功。
# 哪些环境值得优先开启
我会优先在这些环境中考虑 Server HA:
- 生产集群把 Ambari 作为日常启停、扩容、升级和告警入口;
- 集群启用了 Kerberos、LDAP、Ranger 等安全能力,恢复步骤较多;
- 平台有自动化系统持续调用 Ambari API;
- 运维窗口短,无法接受临时重建 Server;
- Ambari Server 所在主机需要进行系统补丁或硬件维护。
测试环境是否开启则取决于目标。如果它只是短期验证组件功能,单节点更简单;如果它承担上线前的故障演练,就应该尽量还原生产的共享数据库、TLS、入口和 Agent 候选配置。
# 建设前先写下验收口径
开始安装第二台 Server 前,我建议先把下面几项写成可测量的结果。
| 验收项 | 建议观察方式 |
|---|---|
| 唯一 Active | 两个节点同时存活时,只有一个 /readiness 返回成功 |
| 自动接管 | 停止 Active 后,Standby 在约定时间内进入 Ready |
| 写请求不重放 | 切换窗口内没有重复的 Request、Stage 或 Agent 命令 |
| Agent 恢复 | Agent 自动连接新 Active,主机状态重新稳定 |
| 任务可追踪 | 切换前已提交任务仍可按原标识查询 |
| 旧节点回归 | 原 Active 恢复后以 Standby 加入,不争抢或覆盖新 Active |
| 入口一致 | 页面和 API 使用方无需临时改地址即可恢复 |
有了这份口径,后面看到“两个进程都在”时就不会过早宣布完成。真正的完成,是角色、数据、入口、Agent 和任务恢复都通过验证。
# 接着看什么
下一篇会进入整套方案的核心:共享数据库里的 Lease 和 Term 怎样选出唯一 Active,写围栏怎样封住旧主节点,以及 Agent 为什么也要参与角色校验。
config:
  target: _self
data:
  - name: 一把租约如何守住唯一 Active
    desc: 继续理解角色、租约、晋升屏障、Agent 选主和入口健康检查。
    link: /v/custom/thoughts/ambari-server-ha/architecture/
    bgColor: '#eefaf4'
    textColor: '#176b4d'
  - name: 直接进入启用实战
    desc: 已经理解边界,可以按页面流程准备、开启并完成故障切换验收。
    link: /v/custom/thoughts/ambari-server-ha/enable/
    bgColor: '#eef6ff'
    textColor: '#1f4e79'
2
3
4
5
6
7
8
9
10
11
12
13