
 Hive
# 基于 Ambari 安装 Hive 高可用
# 方案一:安装时直接选择高可用
在 Hive 的安装过程中,第一种方案是直接在安装时选择高可用配置。此方案非常适合于从一开始就设置高可用模式。
提示
注: 对于这种配置方式,具体的安装流程不再赘述,请参考本站其他文章了解更多关于 Hive 安装的详细内容。

# 方案二:安装后通过添加服务实现高可用
如果你选择了安装简版的 Hive,而后又需要配置高可用,可以按照以下步骤进行:
# 1. 等待服务启动并遇到报错
由于 Ambari 在默认安装过程中没有初始化多节点的 Hive schema,可能会在启动时遇到错误。

错误信息:
0: jdbc:mysql://hadoop1/hive> CREATE TABLE IF NOT EXISTS `COLUMNS_V2` ( `CD_ID`
bigint(20) NOT NULL, `COMMENT` varchar(256) CHARACTER SET latin1 COLLATE latin1_
bin DEFAULT NULL, `COLUMN_NAME` varchar(767) CHARACTER SET latin1 COLLATE latin1
_bin NOT NULL, `TYPE_NAME` MEDIUMTEXT DEFAULT NULL, `INTEGER_IDX` int(11) NOT NU
LL, PRIMARY KEY (`CD_ID`,`COLUMN_NAME`), KEY `COLUMNS_V2_N49` (`CD_ID`), CONSTRA
INT `COLUMNS_V2_FK1` FOREIGN KEY (`CD_ID`) REFERENCES `CDS` (`CD_ID`) ) ENGINE=I
nnoDB DEFAULT CHARSET=latin1
No rows affected (0.01 seconds)
0: jdbc:mysql://hadoop1/hive> /*!40101 SET character_set_client = @saved_cs_clie
nt */
No rows affected (0.001 seconds)
0: jdbc:mysql://hadoop1/hive> /*!40101 SET @saved_cs_client     = @@character_se
t_client */
No rows affected (0.001 seconds)
0: jdbc:mysql://hadoop1/hive> /*!40101 SET character_set_client = utf8 */
No rows affected (0 seconds)
0: jdbc:mysql://hadoop1/hive> CREATE TABLE IF NOT EXISTS `DATABASE_PARAMS` ( `DB
_ID` bigint(20) NOT NULL, `PARAM_KEY` varchar(180) CHARACTER SET latin1 COLLATE
latin1_bin NOT NULL, `PARAM_VALUE` varchar(4000) CHARACTER SET latin1 COLLATE la
tin1_bin DEFAULT NULL, PRIMARY KEY (`DB_ID`,`PARAM_KEY`), KEY `DATABASE_PARAMS_N
49` (`DB_ID`), CONSTRAINT `DATABASE_PARAMS_FK1` FOREIGN KEY (`DB_ID`) REFERENCES
 `DBS` (`DB_ID`) ) ENGINE=InnoDB DEFAULT CHARSET=latin1
No rows affected (0.01 seconds)
0: jdbc:mysql://hadoop1/hive> /*!40101 SET character_set_client = @saved_cs_clie
nt */
No rows affected (0 seconds)
0: jdbc:mysql://hadoop1/hive> CREATE TABLE `CTLGS` ( `CTLG_ID` BIGINT PRIMARY KE
Y, `NAME` VARCHAR(256), `DESC` VARCHAR(4000), `LOCATION_URI` VARCHAR(4000) NOT N
ULL, UNIQUE KEY `UNIQUE_CATALOG` (`NAME`) ) ENGINE=InnoDB DEFAULT CHARSET=latin1
Error: Table 'CTLGS' already exists (state=42S01,code=1050)
Closing: 0: jdbc:mysql://hadoop1/hive
org.apache.hadoop.hive.metastore.HiveMetaException: Schema initialization FAILED! Metastore state would be inconsistent !!
Underlying cause: java.io.IOException : Schema script failed, errorcode 2
org.apache.hadoop.hive.metastore.HiveMetaException: Schema initialization FAILED! Metastore state would be inconsistent !!
	at org.apache.hive.beeline.HiveSchemaTool.doInit(HiveSchemaTool.java:594)
	at org.apache.hive.beeline.HiveSchemaTool.doInit(HiveSchemaTool.java:567)
	at org.apache.hive.beeline.HiveSchemaTool.main(HiveSchemaTool.java:1517)
	at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method)
	at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62)
	at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43)
	at java.lang.reflect.Method.invoke(Method.java:498)
	at org.apache.hadoop.util.RunJar.run(RunJar.java:323)
	at org.apache.hadoop.util.RunJar.main(RunJar.java:236)
Caused by: java.io.IOException: Schema script failed, errorcode 2
	at org.apache.hive.beeline.HiveSchemaTool.runBeeLine(HiveSchemaTool.java:1226)
	at org.apache.hive.beeline.HiveSchemaTool.runBeeLine(HiveSchemaTool.java:1204)
	at org.apache.hive.beeline.HiveSchemaTool.doInit(HiveSchemaTool.java:590)
	... 8 more
*** schemaTool failed ***
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
# 2. 解决方案:重启服务
为了解决该问题,你需要重启所有 Hive 组件。可以通过回到首页并选择 重启服务 来完成。

# 方案二的配置流程
# 1. 回到首页,选择节点并添加服务
点击 Hosts,选择一个没有安装过 HiveServer2 和 Metastore 的节点,在本例中,我们选择了 hadoop1 节点。

# 2. 安装 Metastore 服务
在该节点上点击 ADD,然后选择 Metastore 服务进行安装。

# 3. 安装 HiveServer2 服务
接着,选择 HiveServer2 并进行安装。

# 4. 重启 Hive 组件
安装完毕后,回到首页并重启所有 Hive 组件。

# 配置 HDFS 高可用
在配置 Hive 高可用时,还需要稍微调整 HDFS 的一些配置,确保访问权限和数据安全。
# 1. 修改 HDFS 配置
点击 HDFS > Configs,然后在 Custom core-site 中找到 hadoop.proxyuser.hive.hosts,将其值修改为 *,允许 Hive 访问
HDFS。

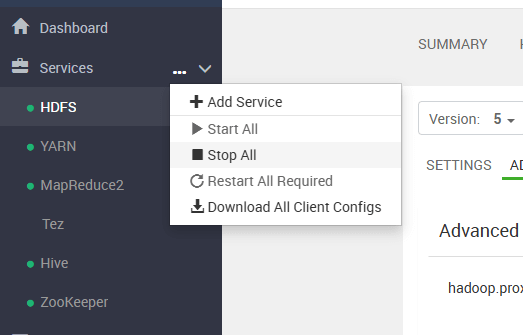
# 2. 重启所有组件
最后,点击 Stop All,然后等待所有组件重新启动。
# 验证高可用配置
完成所有配置和重启后,Hive 的高可用环境应该已经准备好。验证时,我们可以观察到以下现象:
- Metastore 和 HiveServer2 将不再报错。
- 不再有连接不上端口的问题。
- 所有 Hive 组件正常运行。
